Datenblatt
MariaDB GridGain
Verteiltes In-Memory-Caching und Rechenleistung für die Echtzeit-Datenverarbeitung und agentenbasierte KI-Anwendungen
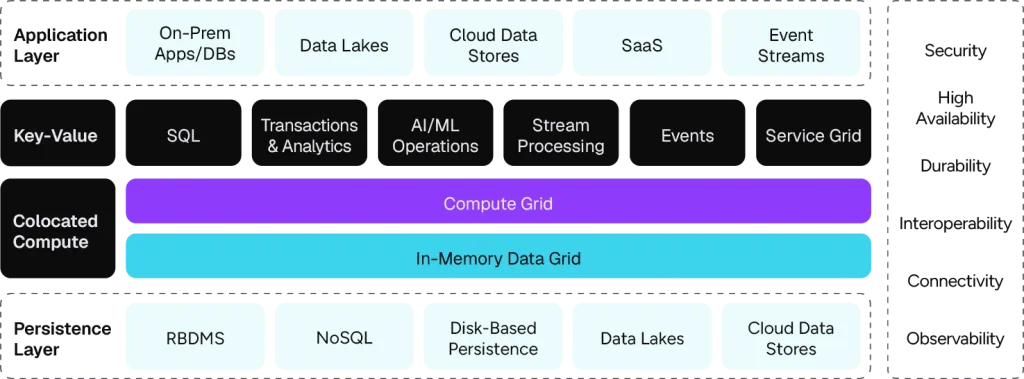
Erweitert die Funktionen der „ MariaDB “Enterprise Platform um eine native, verteilte Caching- und Rechenebene zwischen Ihren Anwendungen und den Quellsystemen. Häufig genutzte Daten und leseintensive Workloads werden in eine „Shared-Nothing“-Speicherebene mit horizontaler Skalierbarkeit verlagert, die Reaktionszeiten im Sub-Millisekundenbereich, ANSI-SQL, ACID-Garantien und kolokierte Rechenleistung bietet. Entwickelt für KI-/ML- und agentenbasierte Anwendungen
- Verteilte Vektorsuche für die Retrieval-Augmented Generation (RAG)
- Semantisches Caching und Agentenspeicher
- Schnelle Bereitstellung von Merkmalen
- Echtzeit-Ausführung von Machine-Learning-Modellen (ML) für die Entscheidungsfindung und die Analyse während der Transaktion
01Architektur
Wird als Peer-to-Peer-Cluster aus Serverknoten bereitgestellt, der Daten über den Arbeitsspeicher des Clusters verteilt und über konfigurierbare Replikate verfügt. Das „Shared-Nothing“-Design verhindert einzelne Ausfallpunkte. Durch das Hinzufügen von Knoten werden die Daten automatisch neu verteilt, und Durchsatz sowie Kapazität lassen sich linear auf Millionen von Transaktionen pro Sekunde (TPS) und Petabyte an Daten skalieren.
02Integration und Beständigkeit
Anwendungen stellen über SQL (JDBC/ODBC) oder native APIs eine Verbindung her. Durch Read-Through-, Write-Through- und Write-Behind-Caching wird die Datenkonsistenz mit „ MariaDB “ oder jedem anderen System of Record gewährleistet. Bei der nativen Persistenz wird der gesamte Datensatz auf der Festplatte gespeichert und so viel davon im Arbeitsspeicher zwischengespeichert, wie der RAM zulässt. Daher können Datensätze die Speichergröße überschreiten, und jeder Knoten skaliert auf Festplattenebene. Nach einem Neustart stellt der Cluster die Daten sofort aus seiner eigenen Kopie bereit, ohne dass ein erneutes Laden aus der Quelle erforderlich ist.
03Colocated Compute
Rechenvorgänge finden dort statt, wo sich die Daten befinden. Durch die Verarbeitung am Speicherort, kontinuierliche Abfragen und die Streaming-Erfassung entfallen Netzwerk-Roundtrips, sodass komplexe Berechnungen innerhalb von Millisekunden anhand von Live-Daten durchgeführt werden können, anstatt in Batch-Jobs über Nacht.
04Wo Kunden es einsetzen
- Anwendungsbeschleunigung: Speichern Sie häufig genutzte Daten im Arbeitsspeicher vor der Datenbank, damit Anwendungen auch bei Zugriffsspitzen schnell bleiben.
- Anwendungsmodernisierung: Beschleunigen Sie eine bestehende Anwendung mithilfe einer In-Memory-Schicht, ohne den Code neu schreiben zu müssen, und migrieren Sie anschließend in Ihrem eigenen Tempo von veralteten oder proprietären Datenbanken wie Oracle und DB2 weg.
- Digitaler Integrationshub – Konsolidieren und kuratieren Sie Daten aus unterschiedlichen Quellsystemen in einem einzigen Echtzeit-Hub, der systemübergreifend verbindet und Antworten innerhalb von Millisekunden liefert.
- Mainframe-Entlastung – Verlagerung von Lesevorgängen mit hohem Datenaufkommen und Rechenaufgaben vom Mainframe, um den MIPS-Bedarf zu senken und alle digitalen Kanäle zu bedienen, während der Kern weiterhin als System of Record fungiert.
- Echtzeit-Entscheidungsfindung – Wenden Sie Geschäftsregeln und ML-Modelle auf Live-Ereignisströme an, um Entscheidungen in Bezug auf Risiken, Betrug und Preisgestaltung direkt zum Zeitpunkt der Interaktion zu treffen.
- Agentenspeicher – Speichert den Status, Checkpoints und sitzungsübergreifende Informationen für KI-Agenten, sodass ein Lauf nach einem Neustart fortgesetzt wird und die nächste Konversation auf dieser Grundlage beginnt.
05Wichtigste Vorteile
- Extrem niedrige Latenz bei enormem Umfang, mit Datenzugriff im Sub-Millisekunden-Bereich
- Die verteilte In-Memory-Architektur ermöglicht massiv-parallele Verarbeitung und lineare Skalierbarkeit auf Millionen von TPS.
- Kollokierte Rechenleistung, die die Geschäftslogik dort ausführt, wo sich die Daten befinden, wodurch der Datentransport über das Netzwerk und die Festplatten-E/A reduziert werden
- Bei der Stream-Verarbeitung und der transaktionalen Analyse werden Entscheidungen innerhalb des Transaktionsfensters getroffen
- Datenintegrität und -konsistenz durch ACID-Konformität, Read/Write-Through und festplattenbasierte Persistenz
- Verteiltes SQL mit vollständigen JOINs und Aggregationen zur Beantwortung von Abfragen im Arbeitsspeicher
- Kontinuierliche Verfügbarkeit über Racks, Rechenzentren und Clouds hinweg
- Senkung der Infrastrukturkosten durch Auslagerung von nicht zum Kerngeschäft gehörenden Datenbankvorgängen und Reduzierung der Mainframe-MIPS
- Ein Anbieter und ein Supportvertrag für den gesamten Datenbereitstellungs-Stack
Von den Top-10-Führungskräften geschätzt
im Bankwesen, in der Telekommunikationsbranche und im Transportwesen
300x
Schnellere Risikoberechnungen: von 3 Minuten auf 600 ms bei einer der fünf weltweit führenden Banken
99.999%
Seit mehr als fünf Jahren ununterbrochene Verfügbarkeit bei einem großen Anbieter von Telekommunikationslösungen
200K
Transaktionen pro Sekunde bei einer nationalen Kreditauskunftei
06Erweiterung der Funktionen des MariaDB Enterprise Platform
MariaDB GridGain bringt verteilte In-Memory-Caching- und Rechenfunktionen nativ in die „ MariaDB “-Umgebung ein – nicht als nachträglicher Zusatz, sondern als tiefgreifende Integration, die speziell für geschäftskritische Daten entwickelt wurde.
- Latenz im Sub-Millisekundenbereich: Verschieben Sie häufig genutzte Daten von der Festplatte in den Arbeitsspeicher und verwandeln Sie minutenlange Abfragen in Antworten im Millisekundenbereich.
- Reibungslose Implementierung: Als transparenter Abfrage-Cache vor MariaDB bereitstellen – ganz ohne Änderungen am Anwendungscode.
- Automatische Datensynchronisierung: Bei „Read/Write Through“- und „Read/Write Behind“-Caching-Mustern macht die native Integration des „ MariaDB “-Cachestores eine benutzerdefinierte Logik zur Invalidierung durch die Anwendung überflüssig.
- Architektonische Konsolidierung: Ersetzen Sie Caching-Schichten von Drittanbietern sowie anfällige Batch- und ETL-Pipelines durch eine einheitliche Plattform.
- Geografisch verteilte Leistung: Erweitern Sie die Reichweite von „ MariaDB“ mit extrem geringer Latenz über Regionen und Rechenzentren hinweg.
- Elastische Skalierbarkeit: Bewältigen Sie Millionen von Anfragen durch Hinzufügen von Knoten und skalieren Sie die Leistung entsprechend dem Anstieg der Datenmengen und des gleichzeitigen Nutzerverkehrs.
- Ansicht einzelner Vorgänge: Überwachen Sie „ MariaDB “-Datenbanken und „ GridGain “-Cluster mit „ Enterprise Manager “.
- Einheitlicher Support für Unternehmen: Ein Partner, ein Vertrag und ein Expertenteam sowohl für die Datenbank als auch für den Cache.