Whitepaper
Versteckte Kosten von RDS und Alternativen
01Einführung in „ Cloud : Database Economics“
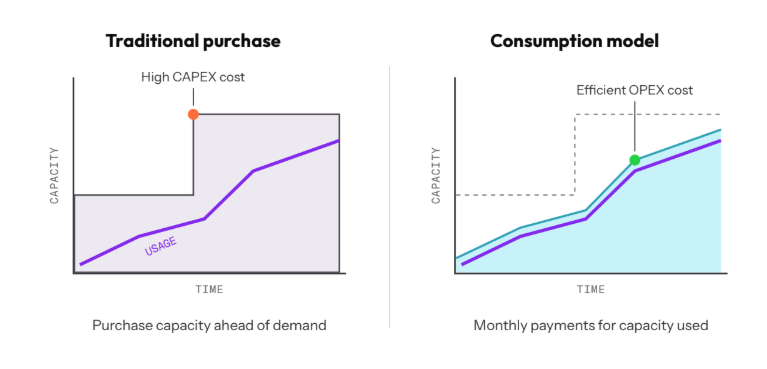
Der grundlegende Wandel von Modellen mit Investitionsausgaben hin zu Modellen mit Betriebsausgaben hat die IT-Budgets von Unternehmen im Laufe des letzten Jahrzehnts systematisch umgestaltet. Im spezifischen Bereich der Verwaltung relationaler Datenbanken wurde dieser Paradigmenwechsel als Mittel gepriesen, um Entwicklerteams von den Zwängen der Hardwarebereitstellung, manueller Software-Patches und der Implementierung komplexer Konfigurationen für die Notfallwiederherstellung zu befreien. Der Amazon Relational Database Service (RDS) entwickelte sich zu einem grundlegenden Eckpfeiler dieses modernen Infrastrukturparadigmas und bietet eine vollständig verwaltete, skalierbare Umgebung für die Bereitstellung, den Betrieb und die Optimierung relationaler Datenbanken in der Cloud. Die durch solche Managed Services bereitgestellte betriebliche Abstraktion führt jedoch zu einer sekundären, hochkomplexen Ebene finanzieller Verpflichtungen.
Die Abrechnungsarchitektur moderner Cloud-Umgebungen hat sich zu einem hochgradig granularen, auf Verbrauch basierenden Rahmenwerk entwickelt, in dem praktisch jeder einzelne Vorgang, jeder Netzwerk-Hop, jeder Rechenzyklus und jede Speichertransaktion individuell quantifiziert und anschließend in Rechnung gestellt wird. 1Diesermehrschichtige Ansatz zur Ressourcenmessung schafft Tausende potenzieller Abrechnungsdimensionen, die weit über die grundlegenden Rechen- und Speicherkosten hinausgehen, die ursprünglich von den Beschaffungsteams modelliert wurden. 1 Mit zunehmender Reife der Cloud-Ökosysteme und der zunehmenden Verteilung von Anwendungsarchitekturen wird der anfängliche Reiz einer vereinfachten Datenbankverwaltung häufig durch unvorhersehbare, undurchsichtige und rasch eskalierende finanzielle Verpflichtungen aufgewogen.
Eine forensische Untersuchung dieser Abrechnungsmechanismen offenbart eine erhebliche und beständige Diskrepanz zwischen den beworbenen Grundkosten für verwaltete Datenbankdienste und den tatsächlich anfallenden Gesamtbetriebskosten in Produktionsumgebungen. Unternehmen stellen häufig fest, dass die Cloud-Rechnungen im Jahr 2026 die ursprünglichen Prognosen deutlich übersteigen – und zwar nicht aufgrund des Wachstums des reinen Speichervolumens oder der Kernanforderungen an die Rechenleistung, sondern aufgrund von Gebühren für den Datenzugriff, Integrationsstrafen und zusätzlichen Observability-Tools.1 Dieseumfassende Analyse zerlegt das Wirtschaftsmodell von Amazon RDS in seine Bestandteile, kategorisiert sowohl die zu erwartenden sichtbaren Kosten als auch die heimtückischen versteckten Gebühren, die sich in modernen Architekturen ansammeln, und untersucht schließlich, wie einheitliche Datenbankplattformen entstehen, um die finanzielle Vorhersehbarkeit wiederherzustellen.
02Was ist RDS?
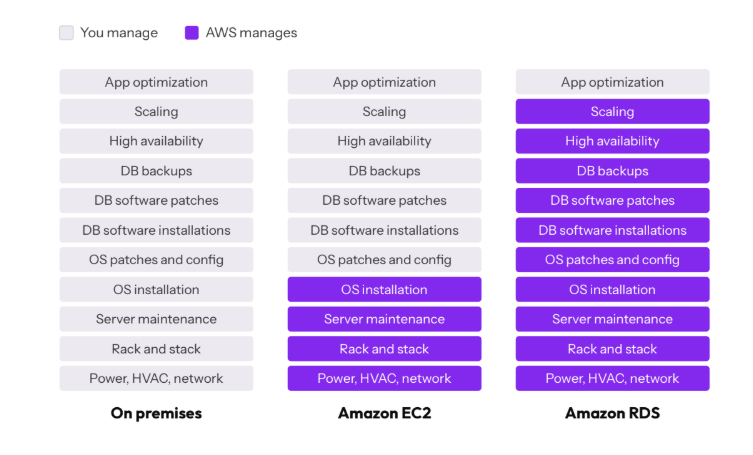
Amazon Relational Database Service ist ein vollständig verwalteter Cloud-Dienst, der von Amazon Web Services (AWS) entwickelt wurde, um die Verwaltung relationaler Datenbanken zu automatisieren. Durch die Abstraktion der zugrunde liegenden Infrastrukturebene ermöglicht Amazon RDS Unternehmen die Bereitstellung hochverfügbarer Datenbankinstanzen, ohne dass der Aufwand für die Verwaltung physischer Hardware, die Konfiguration von Betriebssystemen oder die Installation der Datenbank-Engine auf Basisebene entsteht. Das architektonische Design des Dienstes sieht vor, dass den Nutzern vollständiger Zugriff auf die Datenebene – die Datenbank-Engine selbst und die zugehörigen Schemata – gewährt wird, während der Cloud-Anbieter die uneingeschränkte Kontrolle über die Steuerungsebene übernimmt, die die Automatisierung von Backups, Failovers und Sicherheitspatches umfasst.
Die Plattform ist darauf ausgelegt, ein vielfältiges Ökosystem von Datenbank-Engines zu unterstützen und damit den unterschiedlichen Lizenzanforderungen von Unternehmen sowie den Vorgaben zur Anwendungskompatibilität gerecht zu werden. Zu den unterstützten Engines gehören Open-Source-Standards wie „ MariaDB “, MySQL und PostgreSQL sowie kommerzielle Enterprise-Lösungen wie Oracle Database, Microsoft SQL Server und IBM Db2. Darüber hinaus stellt Amazon eine eigene, cloudnative Datenbank namens Amazon Aurora bereit, die auf umfassende Kompatibilität mit MySQL und PostgreSQL ausgelegt ist, jedoch über ein proprietäres, verteiltes, fehlertolerantes und selbstheilendes Speichersubsystem verfügt, das speziell für die Cloud-Infrastruktur entwickelt wurde.2
Das grundlegende architektonische Konzept von Amazon RDS basiert auf der strikten Trennung von Rechenkapazität und persistenter Speicherung. Diese Entkopplung ermöglicht es Systemadministratoren, diese beiden Hauptressourcen relativ unabhängig voneinander entsprechend den sich ändernden Anwendungsanforderungen zu skalieren. Eine Instanz wird in der Regel innerhalb einer Amazon Virtual Private Cloud (VPC) gestartet, die einen sicheren, isolierten Netzwerkperimeter um die Datenbank herum bildet. Durch dieses Managed-Paradigma wird die Last der routinemäßigen Betriebswartung effektiv von den internen Datenbankadministratoren auf den Cloud-Anbieter verlagert.
Aus Sicht der Lizenzierung und Beschaffung bietet Amazon RDS flexible Nutzungsmodelle. Für kommerzielle Datenbanken wie Microsoft SQL Server und Oracle stellt der Dienst ein „License Included“-Modell bereit, bei dem die Kosten für die Lizenz der proprietären Datenbanksoftware nahtlos in den stündlichen Rechenpreis integriert sind, sodass Unternehmen keine separaten Softwareverträge abschließen müssen.2 Alternativ können Unternehmen, die über bestehende Enterprise-Vereinbarungen verfügen, für bestimmte Datenbanken das „Bring Your Own License“-Modell nutzen, um ihre bisherigen Softwareinvestitionen optimal zu nutzen.5 Für Unternehmen, die die Plattform erst testen möchten, bietet die AWS Free Tier für einen Zeitraum von 12 Monaten eine begrenzte Nutzung bestimmter Instanzgrößen sowie automatisierten Backup-Speicher; danach erfolgt die Abrechnung nach dem standardmäßigen, nutzungsbasierten Modell.2
Füllen Sie das Formular aus, um den Rest zu lesen
03Warum RDS?
Die strategischen Gründe für den Einsatz von Amazon RDS liegen vor allem in der Maximierung der betrieblichen Effizienz, der Minderung systemischer Infrastrukturrisiken und der Beschleunigung der Entwicklungsgeschwindigkeit. Bei einer herkömmlichen, selbstverwalteten Datenbankarchitektur, die auf reinen Recheninstanzen oder lokaler Hardware gehostet wird, tragen Unternehmen die volle und uneingeschränkte Verantwortung für die Gewährleistung der Hochverfügbarkeit, die Konfiguration der Point-in-Time-Wiederherstellung, die Absicherung des Betriebssystems und die manuelle Skalierung von Speichervolumen. Amazon RDS beseitigt diese manuellen Aufgaben systematisch durch hochgradig koordinierte Automatisierung.
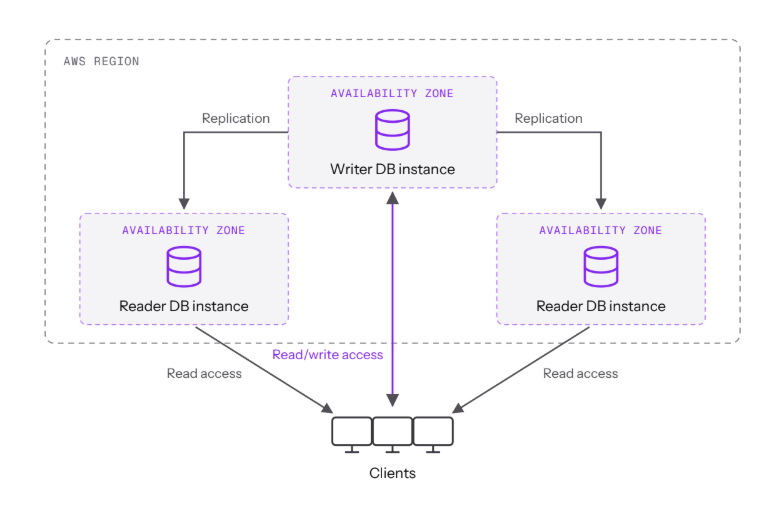
Hohe Verfügbarkeit ist wohl das überzeugendste Merkmal, das die Einführung in Unternehmen vorantreibt. Dies wird durch die Multi-AZ-Bereitstellungsoption erreicht, die automatisch eine synchrone Standby-Replik der Datenbank in einer geografisch getrennten Verfügbarkeitszone innerhalb derselben AWS-Region bereitstellt und verwaltet. Im Falle eines Infrastrukturausfalls, einer Speicherbeeinträchtigung oder einer Netzwerkisolierung, die den Primärknoten betrifft, erkennt die Steuerungsebene die Anomalie und leitet eine automatische Failover-Sequenz ein. Diese Koordination leitet die Datenbankverbindungen der Anwendung auf die Standby-Instanz um, wodurch der Dienst in der Regel mit minimaler Unterbrechung wiederhergestellt wird und sichergestellt wird, dass strenge Recovery Time Objectives (RTOs) und Recovery Point Objectives (RPOs) ohne menschliches Eingreifen eingehalten werden.
Für Anwendungen, die sich durch ein hohes Verhältnis von Lese- zu Schreibvorgängen auszeichnen, ermöglicht der Dienst die Erstellung von Lese-Replikaten. Diese Funktion nutzt asynchrone Replikation, um Daten vom Primärknoten auf mehrere zusätzliche Instanzen zu kopieren, wodurch Architekten leseintensive Abfrage- und Analyse-Workloads von der primären Transaktionsdatenbank auslagern können. Diese Fähigkeit zur horizontalen Skalierung ist entscheidend für kundenorientierte Anwendungen, bei denen es zu plötzlichen Traffic-Spitzen kommt.
Darüber hinaus gewährleisten automatisierte Backup-Protokolle, dass Transaktionsprotokolle und Snapshots der Speichervolumes kontinuierlich in einem äußerst beständigen Objektspeicher archiviert werden. Dieser Mechanismus ermöglicht es Datenbankadministratoren, eine granulare Wiederherstellung zu einem bestimmten Zeitpunkt bis auf die Sekunde genau durchzuführen und schützt das Unternehmen so vor versehentlichem Datenverlust oder böswilliger Manipulation. Routinemäßige Wartungsarbeiten, darunter kritische Sicherheitspatches für das Betriebssystem und kleinere Datenbank-Versions-Upgrades, werden nahtlos innerhalb vordefinierter, vom Kunden gesteuerter Wartungsfenster durchgeführt. Diese Automatisierung gewährleistet die Einhaltung unternehmensinterner Sicherheitsvorgaben und minimiert gleichzeitig das Risiko unbehobener Sicherheitslücken. Für Entwicklungsteams bedeutet die Auslagerung dieser Aufgaben eine direkte Beschleunigung der Bereitstellungszyklen. Durch die Entlastung bei der Infrastrukturwartung können technische Mitarbeiter ihren Fokus und ihre Ressourcen auf wertschöpfende Aktivitäten wie Anwendungsentwicklung, Optimierung logischer Schemata und Leistungsoptimierung komplexer Abfragen verlagern.
04Die sichtbaren Kosten
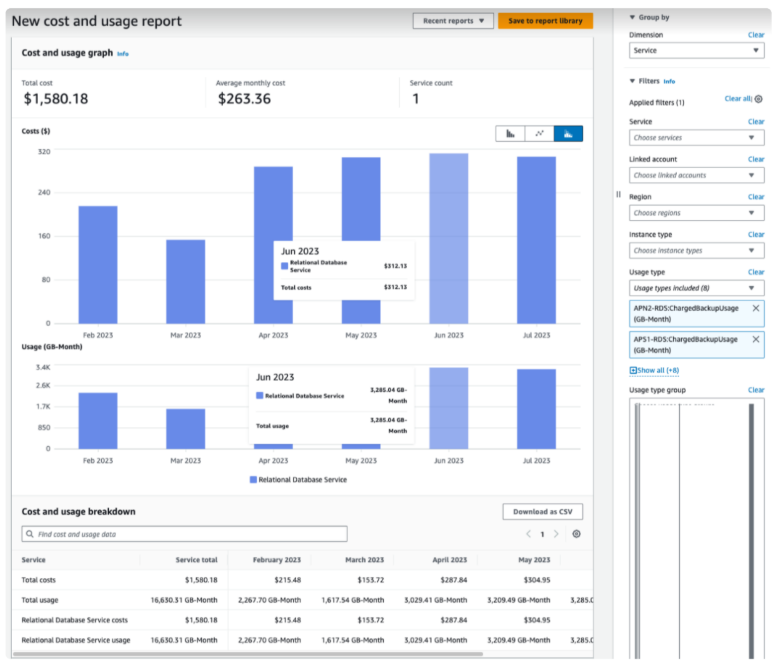
Die grundlegenden Abrechnungsdimensionen von Amazon RDS sind im Allgemeinen gut dokumentiert und machen den Großteil der von den Entwicklerteams erstellten anfänglichen Finanzprognosen aus. Diese primären Kostenfaktoren lassen sich grob in die Bereitstellung von Recheninstanzen, die Zuweisung von persistenten Speichervolumen und grundlegende Datenübertragungsvorgänge unterteilen.7
Preise für Recheninstanzen
Rechenressourcen stellen den wichtigsten und am deutlichsten erkennbaren finanziellen Aufwand bei jeder Amazon RDS-Bereitstellung dar. Die Preisberechnungsalgorithmen richten sich nach einer Kombination aus der ausgewählten Datenbank-Engine, der Instanzfamilie, der Instanzgröße und dem architektonischen Bereitstellungsmodell (Single-AZ gegenüber Multi-AZ). Recheninstanzen werden streng auf Stundenbasis abgerechnet, wobei Teilstunden dynamisch in Schritten von einer Sekunde in Rechnung gestellt werden, wobei für jede abrechnungsrelevante Statusänderung eine obligatorische Mindestgebühr von 10 Minuten anfällt.6
Die Auswahl des zugrunde liegenden Instanzknotens bestimmt direkt die Zuweisung von Zentralprozessoren (CPUs), Arbeitsspeicher (RAM) und dedizierter Netzwerkbandbreite. Instanzfamilien sind grundsätzlich so konzipiert, dass sie je nach ihren spezifischen Ressourcenverhältnissen unterschiedliche Workload-Profile abdecken. Die „Burstable Performance“-Familie, gemeinhin als T-Serie bezeichnet, ist für Entwicklungsumgebungen oder stark schwankende Workloads ausgelegt.⁸ Diese Knoten sammeln in Zeiten geringer Auslastung CPU-Guthaben an und verbrauchen dieses Guthaben bei Traffic-Spitzen. Ist die Instanz im „Unlimited-Modus“ konfiguriert, um eine Leistungsdrosselung zu verhindern, führt jede anhaltende CPU-Auslastung, die über die angesammelten Basis-Credits hinausgeht, rasch zu Zusatzkosten, die pro vCPU-Stunde abgerechnet werden, wodurch bei einer scheinbar pauschal tarifierten Instanz ein variables Kostenelement hinzukommt.8
Die als M-Serie bezeichnete General-Purpose-Familie bietet ein ausgewogenes, symmetrisches Verhältnis zwischen Rechenleistung, Arbeitsspeicher und Netzwerkressourcen. Diese Instanzen bilden das Rückgrat für vorhersehbare, mittelschwere Unternehmens-Workloads, die eine konsistente Basisleistung erfordern, ohne dass extremes Speicher-Caching notwendig ist.8 Umgekehrt sind die speicheroptimierten Produktfamilien, zu denen die R-Serie und die X-Serie gehören, speziell für komplexe, speicherintensive Abfragen und große Datensätze ausgelegt, die umfangreiche In-Memory-Pufferpools erfordern.8 Durch die Maximierung des Verhältnisses von RAM zu vCPU verhindern diese Instanzen, dass die Datenbank-Engine langsame, ressourcenintensive Festplatten-Swapping-Vorgänge ausführt, wodurch die Abfragelatenz aufrechterhalten wird – allerdings auf Kosten eines deutlich höheren Stundensatzes.
Die Bereitstellungsarchitektur hat erhebliche Auswirkungen auf diese Rechen-Baseline. Die Implementierung einer Multi-AZ-Konfiguration verdoppelt effektiv die Gesamtkosten für Rechenleistung, da das Unternehmen sowohl für die primäre Betriebsinstanz als auch für den synchronen, vollständig bereitgestellten Standby-Knoten finanziell verantwortlich ist.5 Unternehmen versuchen, diese sich summierenden On-Demand-Rechenkosten durch die Nutzung von Rabattmechanismen auf Basis von Nutzungszusagen zu mindern. Mit „Database Savings Plans“ und „Reserved Instances“ können Unternehmen Vorhersehbarkeit bei den Investitionskosten und starre, langfristige Nutzungsverpflichtungen (über einen Zeitraum von einem bis drei Jahren) gegen erheblich reduzierte Stundensätze eintauschen, wobei die Höhe des Rabatts davon abhängt, ob die Verpflichtung im Voraus, teilweise im Voraus oder gar nicht bezahlt wird.2
Speicherbereitstellung
Mit Ausnahme von Amazon Aurora, das einen proprietären, automatisch skalierbaren, verteilten Speichercluster nutzt, müssen Systemadministratoren bei Standard-Amazon-RDS-Bereitstellungen explizit persistente Elastic-Block-Store-Kapazität bereitstellen, die in GiB-Monaten gemessen und abgerechnet wird.5
Die Speicherebenen sind nach Leistungsmerkmalen unterteilt. Der Allzweck-SSD-Speicher bietet eine zuverlässige Basis für die Ein-/Ausgabe-Leistung (I/O), die sich hervorragend für die überwiegende Mehrheit der standardmäßigen Transaktions-Workloads eignet. Durch die Weiterentwicklung zur gp3-Ebene können Administratoren IOPS und Speicherdurchsatz völlig unabhängig von der Rohspeicherkapazität bereitstellen, was im Vergleich zu herkömmlichen Speichervolumes einen feineren Mechanismus zur Kostenkontrolle bietet.7
Für latenzempfindliche Anwendungen mit hohem Durchsatz, die eine dauerhafte und garantierte E/A-Konsistenz erfordern, müssen Unternehmen SSD-Speicher mit bereitgestellten IOPS nutzen. Diese Premium-Speicherstufe führt einen Abrechnungsmechanismus mit zwei Komponenten ein. Dem Unternehmen wird eine separate Gebühr für die zugewiesene Speicherkapazität in GiB sowie eine separate, davon unabhängige Gebühr für die genaue mathematische Anzahl der pro Monat bereitgestellten IOPS in Rechnung gestellt. Entscheidend ist, dass dem Unternehmen die bereitgestellte IOPS-Rate in Rechnung gestellt wird, unabhängig von den tatsächlich von der Datenbank verbrauchten E/A-Vorgängen.6
Wenn ein Administrator die Funktion zur automatischen Skalierung des Speichers aktiviert, weist die Steuerungsebene automatisch zusätzliche Blockspeicherkapazität zu, sobald die Auslastungsschwellenwerte dauerhaft überschritten werden. Diese Automatisierung verhindert zwar katastrophale Anwendungsausfälle aufgrund von Speicherplatzmangel, führt jedoch zu einem schleichenden Ratscheneffekt bei der monatlichen Abrechnungsgrundlage. Amazon RDS-Speichervolumes können dynamisch erweitert werden, doch die zugrunde liegende Architektur verhindert, dass sie jemals verkleinert werden können. Dadurch wird sichergestellt, dass jeder vorübergehende Anstieg des Datenvolumens zu einer dauerhaften, irreversiblen Erhöhung der monatlichen Speicherkosten führt.
Ausgehende und eingehende Datenübertragung
Die Preisgestaltung für die Datenübertragung innerhalb der Cloud-Infrastruktur basiert auf einem strengen Prinzip der Grenzüberschreitung. Der eingehende Datenverkehr – insbesondere der Datenfluss aus dem öffentlichen Internet oder externen AWS-Regionen in die Datenbankinstanz – ist völlig kostenlos.10 Diese Richtlinie soll die Ansammlung von Daten innerhalb des Ökosystems des Cloud-Anbieters fördern. Umgekehrt fallen für den ausgehenden Datenverkehr, der von der Datenbank nach außen fließt, nutzungsabhängige Gebühren an, die je nach Zielort variieren.
Daten, die von einer Amazon RDS-Instanz ins öffentliche Internet übertragen werden, werden nach einer gestaffelten, volumenbasierten Preisstruktur abgerechnet. Die Preisstruktur für ausgehende Datenverkehr belastet kleinere Workloads durchweg stärker, während bei sehr großem Umfang nur geringfügige Rabatte gewährt werden.5
| Übertragungsziel | Monatliche Umsatzstufe | Ausgangskosten pro GB |
|---|---|---|
| Internet-Ausgang | Die ersten 10 TB pro Monat | $0.09 |
| Internet-Ausgang | Die nächsten 40 TB/Monat | $0.085 |
| Internet-Ausgang | Über 150 TB pro Monat | $0.070 |
| Regionsübergreifend | Beliebige Menge | $0.02 |
| Zonenübergreifend | Beliebige Menge | 0,01 $ (pro Richtung) |
Tabelle 1: Standard-Ausgangsdatenübertragungsraten zur Veranschaulichung des gestaffelten Preismodells.
Noch kritischer für moderne, verteilte Microservice-Architekturen ist, dass für Daten, die zwischen verschiedenen Verfügbarkeitszonen innerhalb derselben AWS-Region übertragen werden, in beide Richtungen eine Gebühr von 0,01 US-Dollar pro GB anfällt.5 Zwar befreit der Dienst den internen Replikationsverkehr zwischen einem primären Datenbankknoten und seinem synchronen Multi-AZ-Standby ausdrücklich von diesen Gebühren, doch jeglicher AZ-übergreifende Datenverkehr, der durch Anwendungsserver bei Abfragen der Datenbank erzeugt wird, bleibt vollständig abrechnungsfähig.2 In hochverfügbaren Architekturen, in denen Anwendungsflotten zufällig auf drei Verfügbarkeitszonen verteilt sind, sorgt eine mathematische Wahrscheinlichkeit dafür, dass die Mehrheit der Datenbankabfragen eine AZ-Grenze überschreitet, was die monatliche Rechnung für die Datenübertragung unbemerkt in die Höhe treibt.
05Die versteckten Kosten
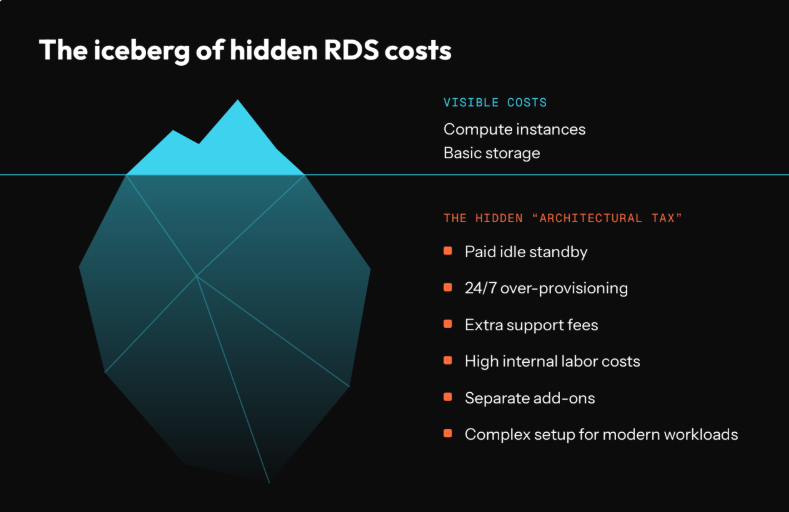
Die wahre Komplexität des Finanzmanagements in der Cloud zeigt sich nicht in den primären Rechen- und Speicherebenen, sondern in den unzähligen Zusatzdiensten, betrieblichen Nachteilen und externen Integrationsmechanismen, die erforderlich sind, um eine produktionsreife Datenbank sicher und effektiv zu betreiben. Diese sekundären und tertiären Abrechnungsdimensionen werden bei der anfänglichen Kostenmodellierung häufig übersehen und summieren sich unbemerkt, während die Arbeitslasten skalieren und die architektonische Komplexität zunimmt.
RDS-Proxy und Verbindungsmanagement
Relationale Datenbank-Engines verbrauchen erhebliche interne CPU- und Speicherressourcen, um offene Client-Verbindungen auszuhandeln, herzustellen und aufrechtzuerhalten. In modernen serverlosen Architekturen, in denen als Reaktion auf Traffic-Spitzen Tausende von kurzlebigen Rechenfunktionen gleichzeitig gestartet werden können, kann die Datenbank ihre begrenzten Verbindungslimits schnell ausschöpfen. Dieses als „Connection Storm“ bezeichnete Phänomen führt zu schwerwiegenden Anwendungs-Timeouts, Speicherengpässen und einer Verschlechterung der Dienstqualität.
Um diese architektonischen Reibungsverluste zu beheben, bietet Amazon den RDS Proxy an, einen vollständig verwalteten, hochverfügbaren Datenbank-Proxy, der zwischen der Anwendung und der Datenbank angesiedelt ist, um bestehende Verbindungen zu bündeln und gemeinsam zu nutzen. Dieser Proxy schützt die Datenbank-Engine zwar wirksam vor einer Erschöpfung der Verbindungen, führt jedoch eine separate, kontinuierliche und erhebliche Abrechnungskomponente ein. Bei bereitgestellten Instanzen wird RDS Proxy mit 0,015 US-Dollar pro vCPU-Stunde abgerechnet, wobei sich der Preis ausschließlich nach der Größe der zugrunde liegenden Datenbankinstanz richtet, die er bedient, wobei eine Mindestgebühr von 2 vCPUs anfällt.13 Wenn ein Unternehmen also eine stark skalierte Flotte von r5.4xlarge-Instanzen mit jeweils 16 vCPUs betreibt, verursacht die Einbindung des Proxy-Mechanismus versteckte Rechenkosten in Höhe von Hunderten von Dollar pro Instanz und Monat. Diese Kosten fallen Stunde für Stunde an, völlig unabhängig vom tatsächlichen Volumen des Anwendungsdatenverkehrs, der die Proxy-Schicht durchläuft.13
Observability: CloudWatch Database Insights und Performance Insights
Eine umfassende Beobachtbarkeit der Datenbank ist eine unverzichtbare betriebliche Anforderung, um langsame Abfrageausführungen zu identifizieren, Transaktions-Deadlocks zu beheben und Indexineffizienzen zu mindern. Amazon RDS erfüllt diese Anforderung, indem „Performance Insights“ bereits bei der Erstellung der Instanz automatisch aktiviert wird. Damit steht ein spezielles grafisches Tool zur Verfügung, mit dem sich die Datenbankauslastung visualisieren und präzise Leistungsengpässe auf Abfrageebene isolieren lassen.14
Die kostenlose Basisversion von Performance Insights bietet eine rollierende Aufbewahrungsfrist von sieben Tagen für den Verlauf der Leistungsdaten und umfasst bis zu einer Million API-Anfragen pro Monat ohne zusätzliche Kosten.15 Eine umfassende Optimierung der Datenbankleistung erfordert jedoch häufig eine Langzeitanalyse der Daten über mehrere Wochen hinweg, um saisonale Schwankungen im Datenverkehr und langfristige Verschlechterungstrends zu erfassen. Die Verlängerung dieses Aufbewahrungszeitraums ist mit erheblichen Mehrkosten verbunden. Wählt ein Administrator eine kostenpflichtige flexible Aufbewahrungsstufe zwischen einem und 24 Monaten, wird dem Unternehmen eine Pauschale von 1,50 US-Dollar pro vCPU und Monat in Rechnung gestellt.15 Bei hoch skalierten Instanzen mit Dutzenden von Kernen entwickelt sich diese „Observability-Gebühr“ schnell zu einem bedeutenden Posten auf der monatlichen Rechnung.
Darüber hinaus durchläuft die Architekturlandschaft für die Datenbank-Observability derzeit eine erzwungene, von den Anbietern vorgeschriebene Migration. Bis zum 30. Juni 2026 werden die native Performance Insights-Konsole und die damit verbundenen flexiblen Preismodelle für die Aufbewahrungsdauer offiziell das Ende ihrer Lebensdauer (End of Life, EOL) erreichen.14 Nutzer werden gezwungen sein, ihre Observability-Workflows in den „Erweiterten Modus“ von Amazon CloudWatch Database Insights zu migrieren. Instanzen, die nicht vor Ablauf der Frist im Jahr 2026 von Administratoren proaktiv aktualisiert werden, werden standardmäßig in einen eingeschränkten „Standardmodus“ versetzt. Dieser Standardzustand führt zum dauerhaften Verlust des Zugriffs auf Leistungsdaten, die älter als sieben Tage sind, sowie zum Wegfall wichtiger Diagnosefunktionen für Ausführungspläne und On-Demand-Sperranalysen.14 Der Übergang zu CloudWatch verursacht für Unternehmen zudem zusätzliche Kosten durch API-Abfragen. Benutzerdefinierte Überwachungs-Dashboards, die häufig aktualisiert werden, generieren enorme Mengen an API-Aufrufen; alle Anfragen, die über das anfängliche Kontingent von 1 Million kostenlosen Aufrufen hinausgehen, werden mit 0,01 US-Dollar pro 1.000 Anfragen abgerechnet, was sich bei Betriebsteams, die Echtzeitüberwachung nutzen, unbemerkt summiert.15
Anwachsender Speicherbedarf für Backups
Datenschutz und Notfallwiederherstellung sind grundlegende Prinzipien von verwalteten Datenbankdiensten. Amazon stellt automatisierten Backup-Speicher ohne zusätzliche Kosten zur Verfügung, wobei diese Zuweisung jedoch streng auf 100 % der insgesamt für eine bestimmte Region bereitgestellten Datenbankspeichergröße begrenzt ist.5 So werden beispielsweise einer aktiven Datenbank, für die 500 GiB Elastic Block Store-Kapazität bereitgestellt wurden, entsprechend 500 GiB kostenloser Backup-Speicher zugewiesen. Strenge Compliance-Vorgaben und Audit-Anforderungen von Unternehmen erfordern jedoch häufig längere Aufbewahrungsfristen für Backups, verbunden mit der routinemäßigen Erstellung manueller Snapshots vor risikobehafteten Anwendungsbereitstellungen.
Wenn das Gesamtvolumen der gespeicherten manuellen Snapshots und automatisierten Transaktionsprotokolle die 100-prozentige Basislinie des bereitgestellten Speichers überschreitet, wird die überschüssige Kapazität mit einem Satz von 0,095 US-Dollar pro GiB-Monat in Rechnung gestellt.5 Eine hochaktive Transaktionsdatenbank, die große Mengen an Transaktionsprotokollen erzeugt, kann diesen kostenlosen Schwellenwert leicht und schnell überschreiten. Entscheidend ist: Wenn ein Infrastrukturadministrator eine Datenbankinstanz vorübergehend anhält, um außerhalb der Geschäftszeiten stündliche Rechenkosten einzusparen, fallen für die Instanz weiterhin dauerhaft Gebühren für das bereitgestellte Speichervolumen und den damit verbundenen Backup-Speicher an.2 Wenn die zugrunde liegende Datenbankinstanz dauerhaft beendet wird, verfällt der Freimengen-Ausgleich sofort, und alle verbleibenden manuellen Snapshots werden anschließend auf unbestimmte Zeit zum vollen Satz von 0,095 $ pro GiB-Monat in Rechnung gestellt.5
Snapshot-Export und S3-Integration
Data-Engineering-Pipelines stützen sich häufig auf Snapshots relationaler Datenbanken, um analytische Data Lakes oder externe Business-Intelligence-Umgebungen zu befüllen. Amazon bietet eine spezielle Funktion, mit der Snapshot-Daten automatisch direkt im Apache-Parquet-Format in den Amazon Simple Storage Service (S3) exportiert werden können. Dieses spaltenorientierte Format ist äußerst vorteilhaft, da es den Speicherbedarf reduziert und die nachgelagerte Verarbeitung durch Abfrage-Engines wie Amazon Athena beschleunigt.16
Diese Bequemlichkeit unterliegt jedoch einer äußerst starren und kostspieligen Preisstruktur. Der Snapshot-Export wird gemessen und mit 0,010 US-Dollar pro GB der gesamten, aggregierten Snapshot-Größe abgerechnet, unabhängig davon, ob der Benutzer Filterregeln anwendet, um nur bestimmte, kleinere Tabellen zu exportieren.5 So fallen beispielsweise bei der Durchführung eines gefilterten Exports einer 10-GB-Teilmenge aus einem riesigen 1-TB-Datenbank-Snapshot Rechenkosten an, die sich ausschließlich auf das gesamte Volumen von 1 TB beziehen. Darüber hinaus ist der Exportvorgang grundsätzlich nicht inkrementell.16 Nachfolgende Exporte von Daten aus genau demselben Snapshot oder der routinemäßige tägliche Export neu erstellter Snapshots lösen bei jeder einzelnen Ausführung eine vollständige Abrechnung für das gesamte Datensatzvolumen aus. Diese gesonderten Kosten für die Exportverarbeitung fallen parallel zu und zusätzlich zu den Standardgebühren für Amazon S3-PUT-Anfragen sowie den laufenden Objekt-Speichergebühren für die Speicherung der resultierenden Parquet-Dateien an.18
Krise bei den Preisen für erweiterten Support
Datenbank-Engines unterliegen strengen Lebenszyklusplänen, die von den Betreibern der Open-Source-Community oder kommerziellen Anbietern vorgegeben werden. Wenn eine Hauptversion das Ende des Lebenszyklus (EOL) in der Community erreicht, stellen die Upstream-Betreiber die Bereitstellung kritischer Sicherheitspatches, Fehlerbehebungen und Leistungsupdates offiziell ein. Um ältere Workloads zu schützen, die aufgrund komplexer Anwendungsabhängigkeiten oder technischer Schulden nicht sofort aktualisiert werden können, bietet AWS ein Programm für erweiterten Support an, das die Bereitstellung kritischer Sicherheitspatches für bis zu drei weitere Jahre garantiert.2
Diese Übergangsfrist fungiert jedoch als aggressiver, eskalierender finanzieller Strafmechanismus, der ausdrücklich darauf ausgelegt ist, Unternehmen zur Durchführung von Upgrades zu zwingen. Mit Wirkung zum 1. März 2026 wurde die Preisstruktur für das dritte Jahr des erweiterten Supports massiv angehoben, wodurch sich die Strafzuschläge für weit verbreitete ältere Datenbank-Engines – insbesondere MySQL 5.7 und PostgreSQL 11.20 – effektiv verdoppelten.
Die finanziellen Auswirkungen dieser Strafgebühr werden streng auf Basis der einzelnen vCPUs und Stunden berechnet. Vor März 2026 betrug der Aufschlag in Regionen wie „US East (Ohio)“ 0,100 US-Dollar pro vCPU-Stunde. Nach Erreichen des Schwellenwerts am 1. März 2026 verdoppelte sich dieser Satz auf 0,200 US-Dollar pro vCPU-Stunde.16
| Größe des Instanzknotens | vCPU-Zuweisung | Monatliche Grundkosten für Rechenleistung (ca.) | Zuschlag für erweiterten Support (nach März 2026) | Gesamtauswirkungen auf die monatlichen Kosten |
|---|---|---|---|---|
| db.m5.large | 2 | ~$124 | +$292 | ~$416 |
| db.r5.2xlarge | 8 | ~$730 | +$1,168 | ~$1,898 |
| db.r5.12xlarge | 48 | ~$4,380 | +$7,008 | ~$11,388 |
Tabelle 2: Die finanziellen Auswirkungen der ab dem 1. März 2026 geltenden Strafpreise für den erweiterten Support (Jahr 3).
Wie die Daten eindeutig belegen, übersteigt der Aufschlag für den erweiterten Support regelmäßig und deutlich die Grundkosten der zugrunde liegenden Recheninstanz selbst.20 Diese Dynamik führt zu katastrophalen, unvorhergesehenen Budgetüberschreitungen für Entwicklerteams, die durch Einschränkungen bei der Anwendungskompatibilität handlungsunfähig sind. Für Unternehmen, die serverlose Bereitstellungen wie Aurora Serverless v2 nutzen, wird der Aufschlag pro Aurora-Kapazitätseinheit und Stunde berechnet, was zu einem gleichbleibenden, skalierbaren finanziellen Risiko bei unvorhersehbaren Workloads führt.2
Die versteckte Netzwerkgebühr: NAT-Gateways und PrivateLink
Strenge Best Practices für die Sicherheitsarchitektur schreiben vor, dass relationale Datenbanken ausschließlich in privaten Subnetzen bereitgestellt werden müssen, ohne direkte Ein- oder Ausgangsverbindungen zum öffentlichen Internet. Zusätzliche architektonische Anforderungen machen jedoch häufig eine ausgehende Internetverbindung erforderlich. Beispielsweise benötigt eine Lambda-Funktion, die sich im selben privaten Subnetz befindet, möglicherweise Zugriff sowohl auf die interne Datenbankinstanz als auch auf eine externe Zahlungs-API eines Drittanbieters, oder die Datenbank selbst benötigt einen ausgehenden Zugriff, um bestimmte Software-Updates abzurufen. Dieses ausgehende Routing wird traditionell über ein NAT-Gateway (Network Address Translation) realisiert.
NAT-Gateways stellen eine der heimtückischsten und am schnellsten anwachsenden versteckten Kosten im Bereich Cloud-Netzwerke dar.21 Ihre Kosten werden anhand von drei sich gegenseitig verstärkenden Faktoren ermittelt:
- Stündliche Bereitstellungsgebühr: Jedes bereitgestellte NAT-Gateway kostet 0,045 US-Dollar pro Stunde, was allein für die Bereitstellung etwa 32,85 US-Dollar pro Monat entspricht – unabhängig davon, ob auch nur ein einziges Byte Datenverkehr durch das Gateway fließt.12 Eine hochverfügbare Architektur der Enterprise-Klasse, die sich über drei Verfügbarkeitszonen erstreckt, erfordert die Bereitstellung von drei unabhängigen NAT-Gateways, wodurch sich die Grundkosten im Leerlauf auf fast 100 US-Dollar pro Monat belaufen.23
- Datenverarbeitungsgebühr: Für jedes Gigabyte an Daten, das das NAT-Gateway durchläuft, fällt eine feste Datenverarbeitungsgebühr in Höhe von 0,045 US-Dollar an.12
- Internet-Ausgangsverkehr: Nach der Verarbeitung durch das NAT-Gateway fallen für den Datenverkehr die üblichen regionalen Gebühren für ausgehenden Datenverkehr an, die in der Regel bei 0,09 US-Dollar pro GB beginnen.12
Folglich kostet die Verarbeitung von einem Terabyte ausgehenden Datenverkehrs, der über ein NAT-Gateway geleitet wird, effektiv 135 US-Dollar (45 US-Dollar für die Verarbeitungsgebühr plus 90 US-Dollar für die Ausgangsgebühr), was eine enorme finanzielle Belastung darstellt, die völlig unabhängig von den zentralen Abrechnungskennzahlen der Datenbank ist.
Alternativ können Netzwerkarchitekten AWS PrivateLink über VPC-Endpunkte nutzen, um den Datenverkehr sicher an andere AWS-Dienste weiterzuleiten, ohne das öffentliche Internet oder ein stark ausgelastetes NAT-Gateway zu durchlaufen. Dies mindert zwar wirksam die hohen NAT-Verarbeitungsgebühren, doch VPC-Endpunkte bringen ihre eigene finanzielle Belastung mit sich: eine stündliche Bereitstellungsgebühr von 0,01 US-Dollar pro Endpunkt und Verfügbarkeitszone sowie eine Datenverarbeitungsgebühr von 0,01 US-Dollar pro GB.12 Ein Unternehmen, das dedizierte Endpunkte für S3, Secrets Manager, CloudWatch und Systems Manager über mehrere Verfügbarkeitszonen hinweg unterhält, verursacht schnell Grundkosten für die Netzwerknutzung in Höhe von mehreren hundert Dollar. Darüber hinaus verursacht die Zuweisung öffentlicher IPv4-Adressen in der gesamten Infrastruktur unvermeidbare, laufende Kosten in Höhe von 0,005 US-Dollar pro Stunde bzw. etwa 3,65 US-Dollar pro Monat und IP-Adresse.12
OLAP-Unterstützung über Redshift und Zero-ETL
Amazon RDS wurde von Grund auf für die Online-Transaktionsverarbeitung (OLTP) entwickelt und optimiert. Seine zeilenbasierte Speicherarchitektur eignet sich hervorragend für die Ausführung schneller Lese- und Schreibvorgänge einzelner Datensätze, weist jedoch erhebliche Leistungseinbußen auf, wenn sie komplexen, tabellenübergreifenden analytischen Abfragen ausgesetzt ist, wie sie für die Online-Analytik (OLAP) typisch sind. Um Business-Intelligence-Analysen in Echtzeit durchzuführen, ohne das primäre Transaktionssystem lahmzulegen, sind Unternehmen gezwungen, ihre relationalen Daten in ein dediziertes, spaltenorientiertes Data Warehouse zu replizieren, insbesondere in Amazon Redshift.26
In der Vergangenheit erforderte die Umsetzung dieser Replikation den Aufbau maßgeschneiderter ETL-Pipelines (Extract, Transform, Load) oder den Einsatz separater CDC-Dienste (Change Data Capture) wie dem AWS Database Migration Service (DMS), Managed Streaming for Apache Kafka (MSK) oder Apache Flink. Die Nutzung von DMS erfordert dedizierte Replikationsinstanzen, die stundenweise nach ihrer Größe abgerechnet werden, sowie zusätzlichen Speicherbedarf für Replikationsprotokolle, Auslagerungsspeicher und Daten-Caching.9 Darüber hinaus skaliert DMS die Rechenkapazität über DMS Capacity Units (DCUs), wobei die Preise stark davon abhängen, ob die Replikation für „Single-AZ“- oder „Multi-AZ“-Ausfallsicherheit konfiguriert ist.9
Um diese komplexe Integration zu optimieren und den Wartungsaufwand für die Pipeline zu reduzieren, hat AWS die Zero-ETL-Integration eingeführt. Diese Funktion verspricht eine nahezu in Echtzeit erfolgende Replikation von Transaktionsdaten aus Quellen wie Amazon Aurora und Amazon RDS direkt in Redshift, ohne dass eigener Code gepflegt werden muss.28 Zwar weist AWS ausdrücklich und wiederholt darauf hin, dass für die Zero-ETL-Integration selbst keine zusätzlichen Gebühren anfallen, doch führen die damit verbundenen architektonischen Anforderungen zu erheblichen, unvermeidbaren Kostensprüngen.26
Die größte finanzielle Gefahr liegt tief in den Funktionsmechanismen von Redshift Serverless und der kontinuierlichen CDC verborgen. Redshift Serverless berechnet die Rechenkapazität in Redshift-Verarbeitungseinheiten pro Sekunde und wendet dabei für jede Aktivität eine Mindestgebühr von 60 Sekunden an.31 Die Zero-ETL-Integration ist auf einen kontinuierlichen, ununterbrochenen Strom von CDC-Ereignissen angewiesen, um eine Datenlatenz nahezu in Echtzeit aufrechtzuerhalten. Dieses dauerhafte Streaming mit geringem Datenaufkommen deaktiviert die nativen Auto-Pause-Funktionen von Redshift Serverless vollständig.30
Darüber hinaus erfordert die Konfiguration einer Redshift Serverless-Arbeitsgruppe als Ziel für eine Zero-ETL-Integration algorithmisch eine strenge Mindestkapazität von 32 Redshift-Verarbeitungseinheiten (RPU).29 Bei einem regionalen Standardtarif von etwa 0,36 US-Dollar pro RPU-Stunde kostet ein aktiver Cluster mit 32 RPUs 11,52 US-Dollar pro Stunde.26 Da der kontinuierliche Zustrom von CDC-Daten verhindert, dass der Cluster jemals in den Ruhezustand wechselt oder auf null heruntergefahren wird, werden Unternehmen 24 Stunden am Tag, sieben Tage die Woche für 32 RPUs in Rechnung gestellt. Dies führt zu absoluten Grundkosten von über 8.200 $ pro Monat allein für den Empfang der replizierten Daten, völlig unabhängig davon, ob jemals eine einzige analytische Abfrage von einem menschlichen Nutzer oder einem BI-Tool ausgeführt wird.30
Erschwerend kommt hinzu, dass die replizierten Daten sehr starr sind. Tabellen, die über Zero-ETL in der Redshift-Umgebung befüllt werden, sind streng schreibgeschützt.30 Um die erforderliche nachgelagerte Dimensionsmodellierung durchzuführen, müssen Dateningenieure sekundäre materialisierte Ansichten oder Transformationstabellen bereitstellen, was den erforderlichen Speicherbedarf für Redshift Managed Storage (RMS) erhöht und zusätzliche Rechen-RPUs für die fortlaufende Datenumstrukturierung beansprucht, was in der Regel zu 30 % bis 40 % mehr Entwicklungsaufwand führt.30
Vektorsuche, RAG und KI-Workloads
Die rasante Verbreitung generativer künstlicher Intelligenz (GenAI) hat die „Retrieval-Augmented Generation“ (RAG) zu einem unverzichtbaren Architekturmuster für moderne Anwendungen gemacht. Die Implementierung von RAG erfordert die Fähigkeit, proprietäre Textdaten in hochdimensionale mathematische Vektoren – sogenannte Embeddings – umzuwandeln und anschließend als Reaktion auf Benutzeranfragen semantische Ähnlichkeitssuchen anhand dieser Vektoren durchzuführen.
Standardmäßigen relationalen Datenbank-Engines fehlen von Haus aus optimierte, leistungsstarke Funktionen zur Vektorverarbeitung. Zwar unterstützt PostgreSQL die beliebte pgvector-Erweiterung, doch birgt deren Einsatz auf einer Standardinfrastruktur erhebliche Betriebsrisiken und führt zu Leistungsengpässen. Algorithmen zur Vektorähnlichkeitssuche, insbesondere hierarchische, navigierbare „Small-World“-Graphen, sind außerordentlich speicherintensiv.32 Wenn eine OLTP-Datenbank gezwungen wird, Millionen hochdimensionaler Einbettungen zu speichern, zu indizieren und abzufragen, führt dies zu einer massiven Belastung der Datenbank-Pufferpools. Dieser Prozess verdrängt standardmäßige relationale Daten aus dem Arbeitsspeicher, zwingt die Datenbank zum Lesen von der Festplatte und beeinträchtigt den transaktionalen Durchsatz erheblich. Zwar führten Aktualisierungen wie die Version 0.8.0 von pgvector iteratives Scannen und eine verbesserte Abfrageplanung ein, doch zwingt die Auslagerung von Vektor-Workloads auf einen relationalen Knoten das Unternehmen fast immer dazu, eine vertikale Skalierung auf äußerst teure, speicherintensive Instanzen der R-Serie durchzuführen, um den Speicherbedarf auszugleichen.32
Um eine Destabilisierung der primären Transaktionsdatenbank zu vermeiden, sind Cloud-Architekten gezwungen, stark fragmentierte, uneinheitliche KI-Ökosysteme zu nutzen. Dies beinhaltet in der Regel die Weiterleitung von Daten aus der Datenbank an Amazon SageMaker zur Erstellung benutzerdefinierter Einbettungen oder den Einsatz von Amazon Bedrock in Verbindung mit Amazon OpenSearch Serverless. Diese stark verteilte Architektur ist außerordentlich komplex und mit hohen Kosten verbunden.
Durch die Integration wird mittels Mindestanforderungen für den Vektorspeicher eine feste Abrechnungsuntergrenze festgelegt. Die Einrichtung einer Wissensdatenbank in Amazon Bedrock löst die automatische Erstellung einer OpenSearch Serverless-Vektorsammlung im Hintergrund aus. Dieser Mechanismus schreibt eine Mindestbereitstellung von zwei OpenSearch Compute Units vor – eine für die Indizierung und eine für die Suchreplikation –, was Kosten von etwa 350 US-Dollar pro Monat verursacht, selbst wenn die Datenbank völlig ungenutzt bleibt und keine Abfragen eingehen.33
Die Umwandlung der relationalen Rohdaten in Vektoren erfordert die Weiterleitung der Daten durch Embedding-Modelle, die auf SageMaker oder Bedrock gehostet werden, was strenge Inferenzgebühren auslöst, die pro Million verarbeiteter Token abgerechnet werden.35 Darüber hinaus erfordern fortgeschrittene RAG-Pipelines ein semantisches Reranking, um die mathematische Genauigkeit der zurückgegebenen Ergebnisse zu verbessern. Die Anwendung von Amazon Rerank 1.0 verursacht einen zusätzlichen Aufschlag von 1,00 US-Dollar pro 1.000 Abfragen.34 Die Nutzung von Bedrock Guardrails zum Filtern bösartiger Eingaben oder halluzinierter Ausgaben führt zu einer weiteren laufenden Verarbeitungsgebühr von 0,30 US-Dollar pro 1.000 Texteinheiten.34 Schließlich erfordert die ständige Notwendigkeit der Datensynchronisation – das Verschieben aktualisierter relationaler Datensätze aus der Quelldatenbank in den OpenSearch-Vektorindex – die Pflege benutzerdefinierter Lambda-Funktionen oder kontinuierlicher Streaming-Pipelines, was dem monatlichen Abrechnungsbeleg eine weitere Ebene an Rechen- und Datenverarbeitungsgebühren hinzufügt.
Die Idle-Standby-Strafe und die Komplexitäten im Aktiv-Aktiv-Betrieb
Obwohl Multi-AZ-Bereitstellungen intensiv als Standard für Hochverfügbarkeit vermarktet werden, bringen sie eine enorme Kostenineffizienz mit sich: Der Standby-Knoten ist rein passiv. Bei einer standardmäßigen Amazon RDS Multi-AZ-Instanzbereitstellung kann die synchrone Standby-Replik nicht zur Bedienung des Leseverkehrs genutzt werden; sie bleibt vollständig ungenutzt, bis ein Failover-Ereignis ausgelöst wird. Das Unternehmen bezahlt somit effektiv 100 % der Rechenkapazität eines sekundären Knotens, der im Normalbetrieb keinerlei Durchsatzwert liefert. Wenn eine Anwendung eine Skalierung der Leseleistung erfordert, muss das Unternehmen zusätzlich zu seiner Multi-AZ-Bereitstellung völlig separate Lesereplikate bereitstellen und dafür bezahlen.
Zudem unterstützt Amazon RDS für MySQL (Versionen 8.0.35 und höher) zwar Aktiv-Aktiv-Architekturen über das Community-Plugin „MySQL Group Replication“, doch handelt es sich hierbei nicht um eine vollständig verwaltete, nahtlose Lösung. Es sind umfangreiche manuelle Konfigurationsschritte erforderlich, und wenn eine Datenbankinstanz nicht wieder in die Gruppe aufgenommen werden kann, müssen Administratoren häufig eingreifen und die Gruppenreplikation manuell neu starten.
Das Fehlen einer nativen automatischen Skalierung der Rechenleistung
Standard-Amazon-RDS unterstützt nativ die automatische Skalierung des Speichers und erweitert den persistenten Blockspeicher nahtlos, wenn die Datensätze wachsen. Es fehlt jedoch ausdrücklich eine native vertikale oder horizontale automatische Skalierung der Rechenleistung. Wenn bei einer Standard-RDS-Instanz (nicht Aurora) ein plötzlicher Anstieg des Datenverkehrs auftritt, verfügt der Dienst über keine integrierte Funktion zur automatischen Skalierung der CPU-Leistung oder des Arbeitsspeichers. Um eine automatisierte Skalierung der Rechenleistung zu erreichen, sind Infrastrukturteams gezwungen, benutzerdefinierte, komplexe Workflows mithilfe von Amazon CloudWatch-Alarmen, Amazon SNS-Benachrichtigungen und AWS Lambda-Funktionen zu erstellen, um Instanzänderungen auszulösen. Da diese selbst erstellte Automatisierung operative Risiken und Ausfallzeiten während der vertikalen Skalierung mit sich bringt, entscheiden sich die meisten Unternehmen einfach dafür, ihre Instanzgrößen dauerhaft überdimensioniert zu dimensionieren, um Spitzenauslastungen bewältigen zu können – was zu massiven Verschwendungen bei den Rechenkosten während der Leerlaufzeiten führt.
Die verborgenen menschlichen Kosten: Datenbankadministratoren
Das Marketingversprechen vollständig verwalteter Cloud-Datenbanken verleitet Unternehmen oft zu der falschen Annahme, dass sie keine Datenbankadministratoren (DBAs) mehr benötigen. Amazon RDS automatisiert Aufgaben auf Infrastrukturebene wie die Bereitstellung von Hardware, die Installation von Betriebssystem-Patches und Backups, basiert jedoch auf einem strengen Modell der geteilten Verantwortung. Kritische Datenbankfunktionen wie Abfrageoptimierung, Indizierungsstrategien, Schema-Design und tiefgreifende Leistungsoptimierung müssen weiterhin vollständig selbst durchgeführt werden. AWS bietet reaktiven Infrastruktur-Support, was bedeutet, dass langsame Abfragen nicht proaktiv optimiert werden. Folglich zahlen Unternehmen einen enormen Aufschlag für Managed Services auf die Recheninstanzen und tragen gleichzeitig die laufenden Kosten für ein festangestelltes, internes DBA-Team, um den effizienten Betrieb der Datenbank sicherzustellen.
06Eine vorhersehbare Alternative: MariaDB Cloud
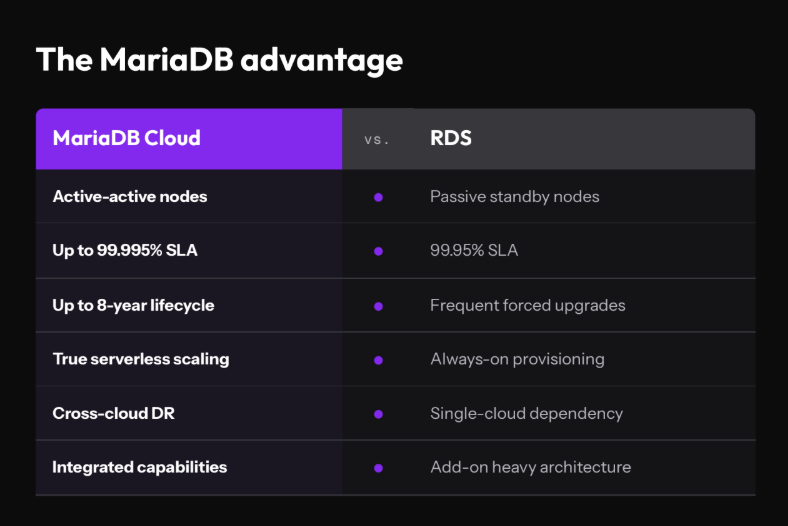
Die sich summierenden, stark verschleierten versteckten Kosten, die mit herkömmlichen verwalteten Datenbankdiensten verbunden sind – und die vor allem durch Proxy-Steuern, erzwungene Migrationen zur Observability, starre und teure ETL-Pipelines sowie fragmentierte, aus mehreren Diensten bestehende KI-Architekturen verursacht werden – verdeutlichen einen systemischen Mangel in stark entbündelten Cloud-Dienstmodellen. Unternehmen, die hohe Leistung ohne die undurchsichtigen Abrechnungsstrukturen anstreben, wenden sich zunehmend von fragmentierten Architekturen ab und setzen stattdessen auf einheitliche, von Grund auf multimodale Datenbankplattformen. „ MariaDB “Cloud, das fortschrittliche serverlose Funktionen umfasst, stellt eine tiefgreifende architektonische Lösung für diese spezifischen finanziellen und betrieblichen Probleme dar.36
Einheitliche Workload-Architektur und HTAP
Der finanziell schädlichste Aspekt des bisherigen relationalen Ökosystems ist die zwingende Notwendigkeit, Daten über mehrere unterschiedliche Dienste hinweg zu duplizieren, um sowohl Transaktionsgeschwindigkeit als auch analytische Tiefe zu erreichen. MariaDB Cloud umgeht dieses Paradigma vollständig durch eine native Architektur für hybride transaktionale und analytische Verarbeitung.38
Durch die tiefe Integration von MariaDB Exa – einer fortschrittlichen, massiv-parallelen In-Memory-Engine mit spaltenorientierter Datenverarbeitung auf Basis von Exasol – ermöglicht MariaDB Cloud die direkte Ausführung komplexer, tabellenumfassender analytischer Abfragen auf Echtzeit-Geschäftsdaten.38 Ein proprietärer, hochintelligenter Abfragebeschleuniger leitet schnelle transaktionale Einfügungen an die herkömmliche zeilenbasierte Engine weiter und ermöglicht gleichzeitig parallele analytische Aggregationen im spaltenorientierten Format.40
Dieses einheitliche, auf einer einzigen Engine basierende Paradigma macht die Konfiguration teurer Zero-ETL-Pipelines vollständig überflüssig, umgeht die einschränkenden Mindestanforderungen von Redshift Serverless (32 RPU) und macht eigenständige AWS-DMS-Replikationsinstanzen überflüssig.38 Indem die grundlegende Notwendigkeit, Daten zur Analyse über Netzwerkgrenzen hinweg zu übertragen, entfällt, umgehen Unternehmen die sich summierenden Gebühren für den datenbereichsübergreifenden Datentransfer, vermeiden Gebühren für die Datenverarbeitung über NAT-Gateways und entgehen den Nachteilen doppelter Speicherung, die mit der Aufrechterhaltung separater, synchronisierter OLTP- und OLAP-Umgebungen einhergehen.41
Native Vektorsuche und Integration von agentenbasierter KI
MariaDB Enterprise Platform MariaDB integriert native Vektorsuchfunktionen direkt in den Kern der Datenbank-Engine.41 Im Gegensatz zu nachträglich hinzugefügten Erweiterungen, die unter erheblichen Komplexitäten bei der Speicherkonfiguration und einer Überlastung des Pufferpools leiden, setzt eine hochoptimierte, native Variante der HNSW-Indizierung um.41 Diese technische Entscheidung integriert die Speicherung und Abfrage von Vektor-Einbettungen nahtlos neben herkömmlichen relational strukturierten Daten, ohne die Transaktionsleistung zu beeinträchtigen.41
Durch die Vereinigung der semantischen Suche mit der Standard-SQL-Syntax können Anwendungen nahtlos zusammengesetzte Abfragen ausführen, die nach exakten relationalen Metriken filtern und gleichzeitig die Ergebnisse nach Vektorähnlichkeit sortieren – und das alles über eine einzige Standard-Datenbankverbindung.41 Dieser nativ multimodale Ansatz vereinfacht die Anwendungslogikebene radikal, macht die Synchronisierung mit dem Vektorspeicher und die Aufrechterhaltung der Konsistenz vollständig überflüssig und reduziert die Angriffsfläche des Unternehmens erheblich, da alle proprietären Daten innerhalb eines einzigen, kontrollierbaren Perimeters verbleiben.41
Darüber hinaus baut MariaDB Cloud auf dieser Grundlage mit einem speziell für agentenbasierte KI entwickelten Model Context Protocol (MCP)-Server auf. Der MariaDB Cloud MCP Server fungiert als Vermittler und ermöglicht es KI-Anwendungen wie Cursor, Claude Desktop und Visual Studio Code Copilot, sicher und effizient mit Ihren MariaDB Cloud -Datenbanken zu interagieren. Er stellt Ihre Daten in einer strukturierten Form bereit, die von KI-Tools abgefragt werden kann, und verwandelt komplexe Datenbankinteraktionen in intuitive Echtzeit-Gespräche.38
Proaktiver Support und RDBA
Im Gegensatz zu den rein reaktiven, ausschließlich auf die Infrastruktur ausgerichteten Supportmodellen traditioneller Cloud-Anbieter bietet MariaDB Cloud mit seinem Remote-DBA-Service (RDBA) einen proaktiven, beratenden Ansatz. Anstatt die Leistungsoptimierung und Abfrageoptimierung den Anwendern selbst zu überlassen, bietet RDBA bedarfsorientierte DBA-Dienstleistungen für die fachkundige Datenbankwartung, gründliche Fehlerbehebung und maßgeschneiderte Strategien zur Skalierung der Architektur.3 Dadurch entfallen direkt die versteckten Personalkosten für den Unterhalt großer, teurer interner Datenbankadministrationsteams, während gleichzeitig sichergestellt wird, dass die Plattform mit maximaler Effizienz läuft.
Transparente und vorhersehbare Wirtschaftspolitik
MariaDB Cloud basiert auf einer transparenten, in hohem Maße vorhersehbaren, gestaffelten Finanzstruktur, die sich aktiv gegen die auf Mikromessung ausgerichteten Konzepte breiterer Public-Cloud-Ökosysteme wendet. Die Plattform bietet von Anfang an ein einheitliches Nutzererlebnis, ohne dass komplexe architektonische „Herausfindungsarbeiten“ erforderlich sind, um eine vorhersehbare Abrechnung zu erreichen. Die Plattform ist in drei primäre, All-inclusive-Angebote unterteilt:
- Foundation: Eine vollständig verwaltete Variante des „ community server “, die sich hervorragend für Entwicklungsumgebungen und grundlegende Produktionsabläufe eignet und eine kostenlose Nutzungsstufe für Entwickler bietet.38
- Leistung: Eine Bereitstellung auf Unternehmensniveau, die kontinuierliche Verfügbarkeit, HTAP-Analysen in Echtzeit über MariaDB Exa , native KI- und Vektorsuchfunktionen sowie erweiterte Supportmechanismen bietet – und das bereits ab äußerst wettbewerbsfähigen Stundensätzen von 0,16 US-Dollar pro Stunde.38
- PowerPlus: Die höchste Stufe, ab 0,21 US-Dollar pro Stunde, die geografisch verteilte Ausfallsicherheit umfassend beinhaltet, ohne dass zusätzliche Serviceabonnements erforderlich sind.38
Entscheidend ist, dass die serverlose Architektur mehrere versteckte Kostenfaktoren von Haus aus beseitigt. Die automatische Skalierung des Speichers erfolgt intelligent und vollkommen transparent: Sie wird dynamisch erweitert, ohne dass versteckte, hohe IOPS-Strafen anfallen oder zusätzliche Kosten durch eine überdimensionierte Speicherschicht entstehen. Die Preisgestaltung für den Primärspeicher ist in hohem Maße vorhersehbar und nutzt standardmäßige AWS-gp3-Volumes zu einem Pauschalpreis von 0,1000 US-Dollar ohne undurchsichtige Multiplikatoren.³⁸ Darüber hinaus gewährleistet die Integration eines intelligenten Proxy-Routing-Systems direkt in die Architektur „ MariaDB “Cloud , dass ständig aktive Verbindungen und die Verwaltung komplexer Sitzungszustände reibungslos und automatisch abgewickelt werden. Diese native Funktion macht die Beschaffung, Konfiguration und Finanzierung externer Rechenebenen für das Connection-Pooling dauerhaft überflüssig und beseitigt vollständig die mit alternativen verwalteten Datenbankdiensten verbundenen, manuell integrierten Proxy-Kosten.47
Die Gesamtbetriebskosten für eine verwaltete Datenbankinfrastruktur lassen sich nicht genau modellieren, indem man lediglich die Grundtarife für Recheninstanzen und die bereitgestellte Speicherkapazität isoliert betrachtet. Die tatsächliche wirtschaftliche Belastung liegt tief in der erforderlichen architektonischen Peripherie verborgen: die Netzwerkkosten für NAT-Gateways und die Replikation über AZs hinweg, die drastischen Strafzuschläge bei erzwungenen Migrationen im Rahmen des erweiterten Supports, der nicht-inkrementelle Charakter von Datenexporten sowie die erzwungene Abhängigkeit von stark kontingentierten, fragmentierten externen Diensten für moderne Analysen und künstliche Intelligenz. Durch die Konsolidierung von OLTP-, OLAP- und Vektoroperationen in einer einzigen, einheitlichen und intelligent skalierten Engine bieten Alternativen wie MariaDB Cloud ein mathematisch überlegenes, vorhersehbares Wirtschaftsmodell. Diese Konvergenz beseitigt anhaltende Rechenkostenaufschläge und führt die Datenbankinfrastruktur erfolgreich zu ihrem grundlegenden Ziel zurück: zuverlässige, leistungsstarke Datenverarbeitung ohne versteckte Betriebskosten.
Erste Schritte mit MariaDB Cloud
07Quellen und Literaturangaben
- Der ultimative Leitfaden zu den Preisen für Cloud-Speicher im Jahr 2026: Versteckte Gebühren, Cloud -Kosten und wie man zu hohe Kosten vermeidet – https://medium.com/@orboncloud/the-ultimate-guide-to-cloud-storage-pricing-in-2026-hidden-fees-egress-costs-how-to-avoid-b8e7bcac2c5d
- Preise für Amazon RDS – https://aws.amazon.com/rds/pricing/
- OpenWorks 2023 – SkySQL vs. AWS RDS vs. GCP Cloud SQL – https://mariadb.com/wp-content/uploads/2023/05/OpenWorks-2023-SkySQL-vs-AWS-RDS-vs-GCP-Cloud-SQL-Venkat-Iyer.pdf
- Preise für Amazon RDS für SQL Server – https://aws.amazon.com/rds/sqlserver/pricing/
- Amazon RDS-Preise | Alle Kosten pro Engine und versteckte Gebühren (2026) – https://go-cloud.io/amazon-rds-pricing/
- Preise für Amazon RDS für „ MariaDB “ –https://aws.amazon.com/rds/mariadb/pricing/
- Abrechnung von DB-Instanzen für Amazon RDS – https://docs.aws.amazon.com/AmazonRDS/latest/UserGuide/User_DBInstanceBilling.html
- Der ultimative Leitfaden zu den AWS RDS-Preisen: Eine umfassende Kostenaufschlüsselung für 2025 – https://cloudchipr.com/blog/rds-pricing
- AWS DMS-Preise – https://aws.amazon.com/dms/pricing/
- Übersicht über die Datenübertragungskosten bei gängigen Architekturen – https://aws.amazon.com/blogs/architecture/overview-of-data-transfer-costs-for-common-architectures/
- Eine Untersuchung der Datenübertragungskosten für verwaltete Datenbanken von AWS –https://aws.amazon.com/blogs/architecture/exploring-data-transfer-costs-for-aws-managed-databases/
- Der umfassende Leitfaden zu den Netzwerkkosten bei „ Cloud “: VPCs, NAT-Gateways und Datentransfer – https://zop.dev/resources/blogs/the-complete-guide-to-cloud-networking-costs-vpcs-nat-gateways-and-data-transfer/
- Preise für Amazon RDS Proxy https://aws.amazon.com/rds/proxy/pricing/
- Überblick über Leistungsdaten zu Amazon Aurora – https://docs.aws.amazon.com/AmazonRDS/latest/AuroraUserGuide/USER_PerfInsights.Overview.html
- Preise für Performance Insights – https://aws.amazon.com/rds/performance-insights/pricing/
- Preise für Amazon RDS für MySQL – https://aws.amazon.com/rds/mysql/pricing/
- Exportieren von Datenbank-Snapshot-Daten nach Amazon S3 für Amazon RDS https://docs.aws.amazon.com/AmazonRDS/latest/UserGuide/USER_ExportSnapshot.html
- Preise für Amazon Aurora – https://aws.amazon.com/rds/aurora/pricing/
- Preise für Amazon S3 – https://aws.amazon.com/s3/pricing/
- Amazon RDS-Preise: Für Nutzer von MySQL 5.7 fällt nun eine Gebühr von 292 US-Dollar pro Monat an – https://cloudburn.io/blog/amazon-rds-pricing
- Die versteckte „ Cloud “-Steuer: Wie IPv4-Mieten und Egress-Gebühren die Budgets für 2026 still und leise belasten – https://www.cloudcostchefs.com/blog/cloud-networking-costs-ipv4-egress-2026
- Amazon VPC-Preise: 4 Kosten, die sich hinter der kostenlosen VPC verbergen – https://cloudburn.io/blog/amazon-vpc-pricing
- Die versteckte Gebühr von 33 $ pro Monat: Die Kosten für das AWS NAT Gateway verstehen –https://dev.to/cloudwiseteam/the-silent-33month-charge-understanding-aws-nat-gateway-costs-19c3
- Ich versuche, die NAT-Preise besser zu verstehen: r/aws – https://www.reddit.com/r/aws/comments/1b83lu1/trying_to_better_understand_nat_pricing/
- Preise für AWS PrivateLink – https://aws.amazon.com/privatelink/pricing/
- Preise für Amazon Redshift – https://aws.amazon.com/redshift/pricing/
- Preise für Amazon Redshift: Was Sie erwarten können und wie das Angebot im Vergleich abschneidet – https://www.rudderstack.com/blog/amazon-redshift-pricing/
- Vereinfachen Sie die Datenintegration mithilfe von Zero-ETL von Amazon RDS zu Amazon Redshift – https://aws.amazon.com/blogs/database/simplify-data-integration-using-zero-etl-from-amazon-rds-to-amazon-redshift/
- Zero-ETL-Integrationen – Amazon Redshift – https://docs.aws.amazon.com/redshift/latest/mgmt/zero-etl-using.html
- AWS Zero-ETL für Redshift: Vorteile in Echtzeit, versteckte Fallstricke – https://medium.com/@amitmeme/aws-zero-etl-to-redshift-real-time-wins-hidden-traps-and-the-cost-smart-path-to-production-b15d0b5e5928
- Preise für Amazon Redshift – https://www.amazonaws.cn/en/redshift/pricing/
- Deutliche Steigerung der Leistung und Relevanz bei der Vektorsuche mit pgvector 0.8.0 auf Amazon Aurora PostgreSQL – https://aws.amazon.com/blogs/database/supercharging-vector-search-performance-and-relevance-with-pgvector-0-8-0-on-amazon-aurora-postgresql/
- Amazon OpenSearch Service – Preise – https://aws.amazon.com/opensearch-service/pricing/
- Preise für Amazon Bedrock: Hinter den Token-Preisen verbirgt sich eine Falle von 350 $ pro Monat – https://cloudburn.io/blog/amazon-bedrock-pricing
- Preise für Amazon Bedrock https://aws.amazon.com/bedrock/pricing/
- MariaDB Beschleunigt „ Cloud “-Bereitstellungen und erweitert das Angebot durch „Agentic AI“ und serverlose Funktionen dank der Übernahme von SkySQL – https://mariadb.com/newsroom/press-releases/mariadb-accelerates-cloud-deployments-adds-agentic-ai-and-serverless-capability-with-acquisition-of-skysql/
- Ankündigung der Veröffentlichung von „ MariaDB “Enterprise Platform 2026 – https://mariadb.com/resources/blog/announcing-the-release-of-mariadb-enterprise-platform-2026/
- MariaDB Cloud Preise – https://mariadb.com/pricing/#mariadb-cloud
- MariaDB Enterprise Platform Übersicht – https://mariadb.com/resources/datasheets/mariadb-enterprise-platform/
- MariaDB vereint transaktionale, analytische und Vektordatenbanken in der Version 2026 der „ MariaDB “Enterprise Platform – https://sdtimes.com/data/mariadb-unifies-transactional-analytical-and-vector-databases-in-mariadb-enterprise-platform-2026-release/
- Einführung der Vektorsuche mit der neuesten Version von „ MariaDB “ – https://mariadb.com/resources/blog/introducing-vector-search-with-the-latest-version-of-mariadb-enterprise-platform/
- Vielseitigkeit bei Datenbank-Workloads – https://mariadb.com/products/enterprise/workload-versatility/
- Auswertung von Vektorindizes in „ MariaDB “ und „pgvector“: Teil 1 – http://smalldatum.blogspot.com/2025/01/evaluating-vector-indexes-in-mariadb.html
- Einführung in die Vektorsuche in „ MariaDB “ – Severalnines – https://severalnines.com/blog/introduction-to-mariadb-vector-search/
- Vergleich zwischen „ MariaDB “ und „SkySQL“ im Jahr 2026 – https://slashdot.org/software/comparison/MariaDB-vs-SkySQL/
- SkySQL- MariaDB . vs. AWS Aurora MySQL: Preis-Leistungs-Vergleich – https://skysql.com/blog/skysql-mariadb-vs-aws-aurora-mysql-a-price-performance-comparison
- MariaDB Cloud Serverless – https://mariadb.com/docs/mariadb-cloud/readme/serverless
- Preise für Unternehmensdatenbanken für „ MariaDB “ – https://mariadb.com/pricing/